
NVIDIA lanzó Nemotron 3.5 Super VL, un modelo abierto de 120 mil millones de parámetros dirigido a agentes especializados en operación continua, con foco en velocidad de conclusión de tareas y en precisión.
Junto con él llegan dos modelos para el edge: Nemotron 3.5 Bolt 74B-A9B 24GB, equilibrado entre inteligencia y velocidad por GB para cargas de trabajo locales basadas en agentes, y Nemotron 3.5 Bolt E4B 4GB, optimizado para inteligencia por GB en agentes de conversación rápidos.
Super VL y Bolt 74B-A9B ya están disponibles. Bolt E4B llega el 23 de octubre.
En conjunto, los tres modelos abiertos cubren todo el rango de despliegue de agentes, desde el servidor corporativo de gran porte hasta dispositivos de edge y hardware local.
Cualquier organización que quiera ejecutar agentes en infraestructura NVIDIA cuenta ahora con un modelo abierto y optimizado para su nivel, sin tener que elegir entre capacidad y facilidad de despliegue.
Super VL y Bolt se suman a la familia Nemotron junto a Lightning y Ultra.
Lightning, lanzado en agosto, atiende cargas de trabajo de alta tasa de transferencia; Ultra se encarga de las tareas de razonamiento más difíciles; y Bolt lleva inteligencia al edge.
Nemotron 3.5 Super VL: precisión de nivel de frontera con un quinto del tamaño
Desarrollado en colaboración con la Nemotron Coalition, Super VL entrega precisión destacada en tareas multimodales basadas en agentes: seguir instrucciones, usar herramientas, ejecutar flujos de trabajo corporativos de varias etapas e interpretar contenido visual. El resultado es comparable al modelo de razonamiento más grande de NVIDIA, con cerca de un quinto del conteo de parámetros.
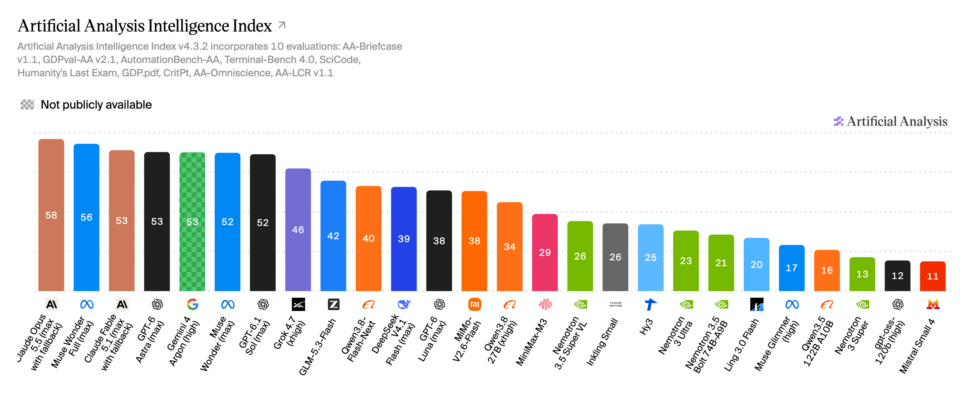
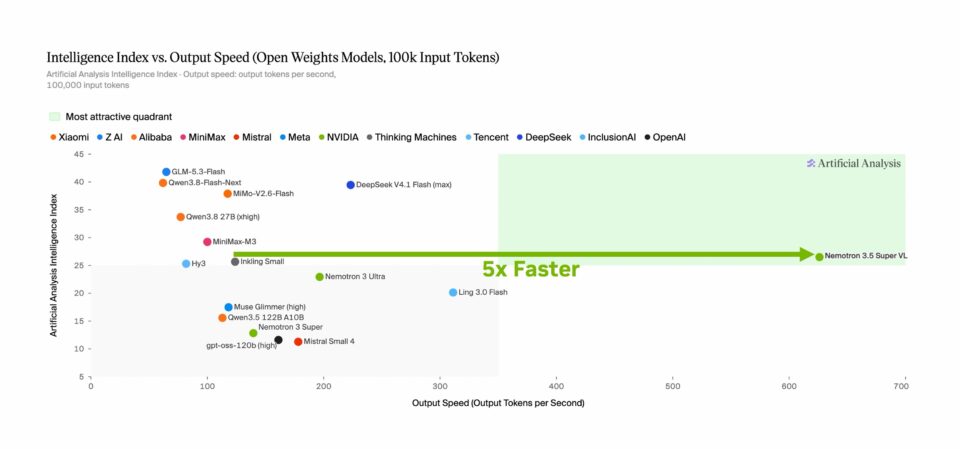
Según el Artificial Analysis Intelligence Index, es el modelo abierto basado en agentes más rápido de su clase, 5x más rápido que el segundo lugar, lo que ayuda a los agentes corporativos a completar tareas de alto volumen en flujos que se extienden por días o semanas.
A diferencia de los modelos de frontera cerrados, las organizaciones pueden post-entrenar Super VL con sus propios datos, desplegarlo en su propia infraestructura y supervisar lo que construyen.
Nemotron 3.5 Bolt: inteligencia basada en agentes en el edge
Bolt 74B-A9B 24GB fue diseñado para ejecutar tareas cotidianas basadas en agentes de forma local en sistemas NVIDIA RTX, con cuantización nativa de 2 bits para caber en 24 GB de memoria y ejecutarse junto a otras aplicaciones.
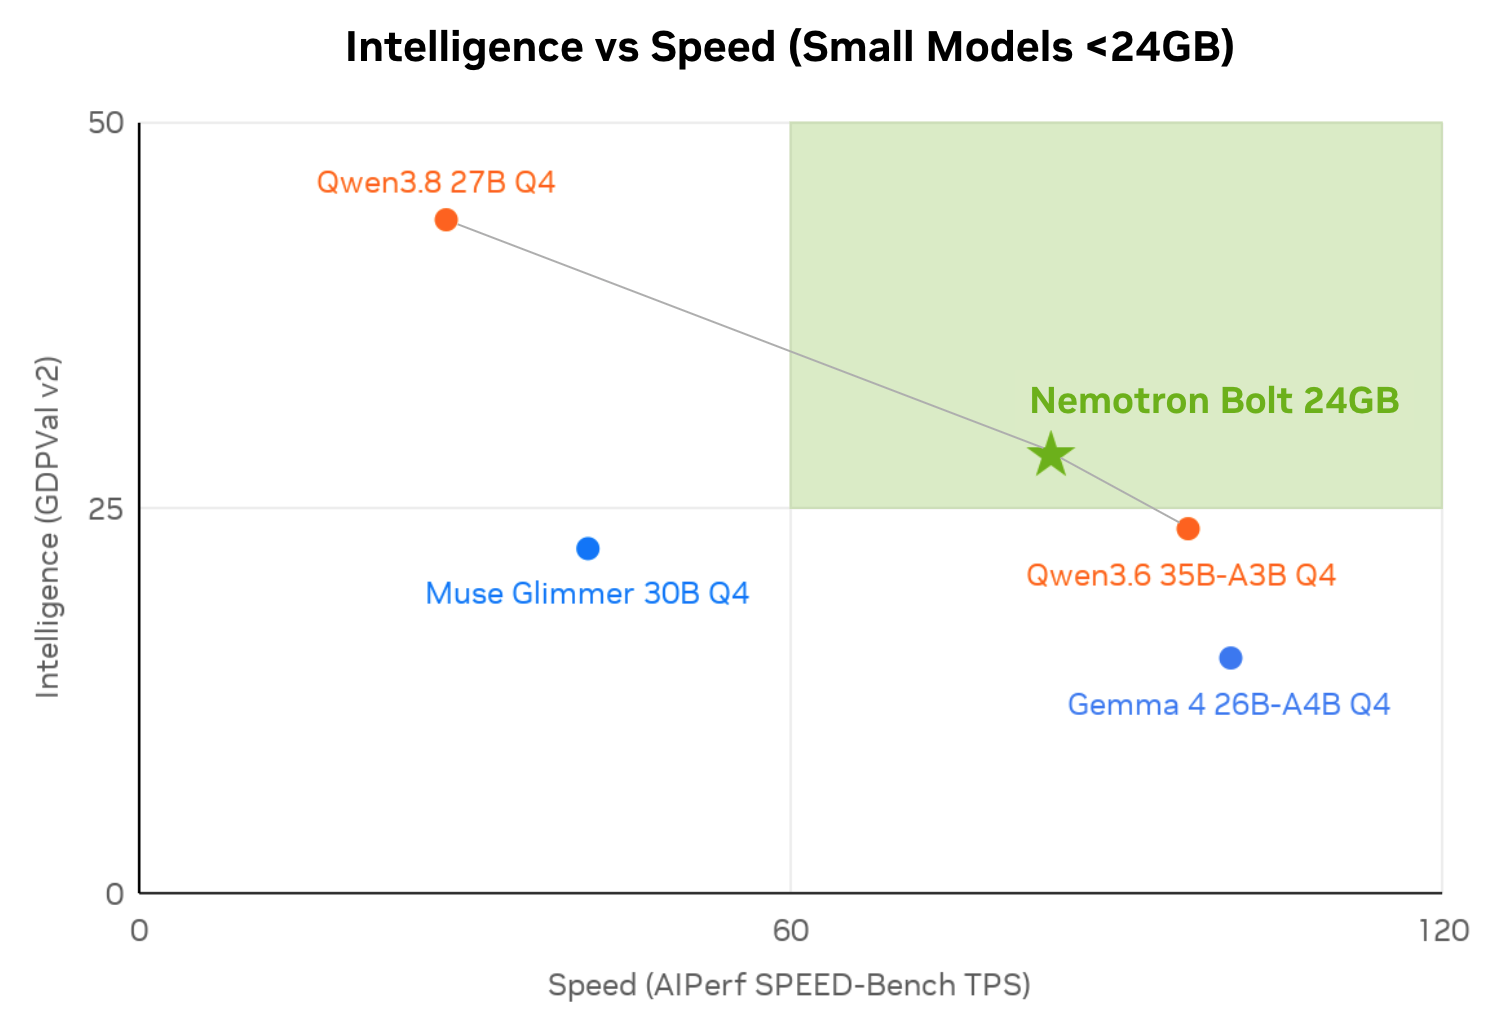
Frente a otros modelos con una huella de memoria similar, ofrece un buen equilibrio entre inteligencia y velocidad: suficientemente inteligente para resolver la mayoría de las tareas y bastante más rápido que los modelos más inteligentes.
Con Bolt 74B-A9B 24GB es posible delegar proyectos a harnesses populares de agentes locales, desde la búsqueda en la web hasta la escritura y la depuración de código, sin enviar esas cargas de trabajo a la nube. Es el modelo abierto n.º 1 de su clase en PinchBench y el n.º 2 entre los modelos abiertos en BrowseComp.
Bolt E4B 4GB fue creado para agentes físicos y de conversación en GeForce RTX y NVIDIA Jetson. Combina conversación natural con capacidades de agente en múltiples turnos para habilitar asistentes de voz locales rápidos, personajes interactivos e interfaces embebidas.
Adopción del Super VL personalizado
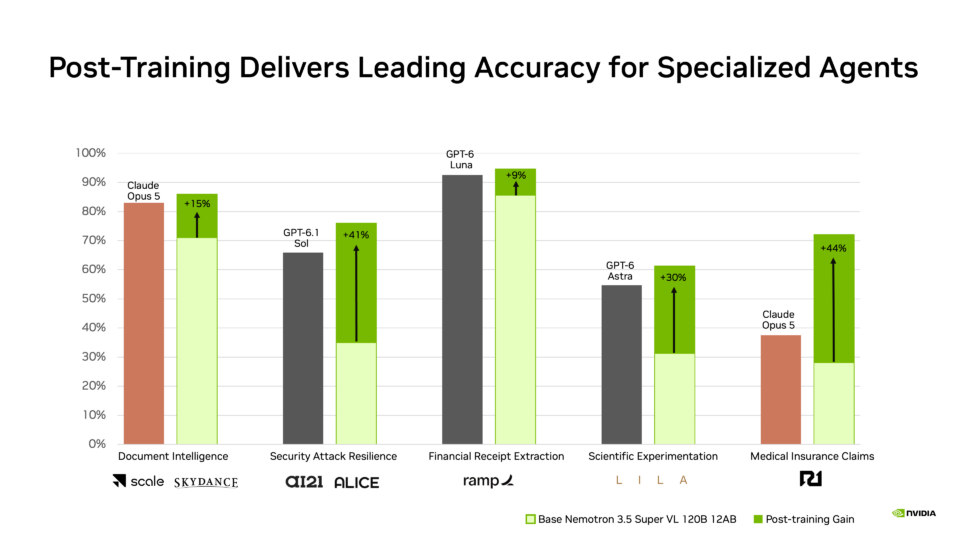
Decenas de organizaciones de distintos sectores están post-entrenando Super VL con datos, herramientas, políticas y flujos de trabajo propios para elevar la precisión en las tareas especializadas que definen sus despliegues de agentes.
Scale AI post-entrenó el modelo para el agente de crédito a proveedores de Skydance y para el agente de due diligence de fusiones y adquisiciones de EY. AfterQuery personalizó el modelo para Hebbia, en análisis de contratos de crédito. AI21 y Alice post-entrenaron el modelo para resiliencia ante ataques de ciberseguridad. Mercor post-entrenó el modelo en el benchmark de código APEX-SWE, para agentes que planean, escriben y depuran código. ModelScope permite hacer fine-tuning del modelo mediante su framework ms-swift para aplicaciones multimodales especializadas.
Otras organizaciones que personalizan Nemotron 3.5 Super VL incluyen a Ramp, para inteligencia de documentos financieros; Dream, en investigación de ciberseguridad y análisis de vulnerabilidades con IA nacional; Lila Sciences, para descubrimiento y búsqueda científica; y R1, para análisis de reclamaciones médicas y gestión del ciclo de ingresos. TrainLoop post-entrenó el modelo con datos de dermatología de Nolla, empresa que recibió aprobación para el uso de IA en la emisión de recetas iniciales a pacientes.
Entre las empresas de plataforma de software que están integrando Nemotron 3.5 Super VL:
- Atlassian, para tareas como búsqueda basada en agentes en aplicaciones como Jira y Confluence.
- CrowdStrike, que está personalizando el modelo para blue teaming basado en agentes en seguridad corporativa.
- Dassault Systèmes, en diseño y simulación de ingeniería.
- Perplexity, para búsqueda y tareas basadas en agentes en Perplexity Search y Computer.
- Salesforce, que está personalizando Nemotron para agentes de IA que digitalizan y automatizan flujos de trabajo gubernamentales complejos en entornos seguros de clientes, mediante Missionforce Operations.
- Synopsys, cuyo software de verificación de diseño de semiconductores interopera con el modelo.
Qué ve Nemotron 3.5 Super VL
Las fortalezas de lenguaje y visión de Nemotron 3.5 Super VL apuntan a lo que los agentes encuentran en la práctica: reconocimiento óptico de caracteres, tablas, gráficos e información estructurada en documentos visuales.
El modelo procesa una página web, extrae texto, lee gráficos y tablas y devuelve insights a partir de lo que encuentra. Lo mismo aplica a archivos PDF y otros documentos con los que los agentes suelen trabajar.
Nemotron 3.5 Super VL entiende imágenes, páginas web y archivos PDF, y actúa con base en ese entendimiento. Combinar comprensión de texto y de imagen en un solo modelo significa que los agentes no necesitan enrutar tareas entre sistemas separados: el contexto se mantiene mientras el trabajo avanza del documento al dato y de ahí a la decisión.
Abierto para mayor control, seguridad y privacidad
Apertura y personalización se refuerzan entre sí. El modelo viene con pesos abiertos, datasets abiertos y recetas de entrenamiento.
El control opera en dos sentidos. Las organizaciones pueden ejecutar el modelo donde sus requisitos de seguridad y de residencia de datos lo determinen. Y eligen adoptar un modelo que pueden adaptar, en lugar de uno sujeto a las restricciones de un proveedor.
En seguros, por ejemplo, un agente personalizado puede revisar reclamaciones en busca de indicios de fraude de forma recurrente. En servicios financieros, un agente puede revisar scores de crédito y señalar actividades frente a los criterios de otorgamiento de la propia organización. El modelo permanece on-premises. Los datos permanecen privados.
La personalización se realiza con NVIDIA NeMo, pipelines en Python y datasets abiertos.
Nemotron 3.5 Super VL fue entrenado con cerca de 26 billones de tokens entre preentrenamiento y preentrenamiento continuado, y después post-entrenado con aproximadamente 3.8 millones de muestras y aprendizaje por refuerzo en decenas de entornos.
NVIDIA también está publicando datasets abiertos en Hugging Face que cubren uso de herramientas por agentes, finanzas, seguimiento de instrucciones, contexto largo, equidad y comprensión de lenguaje y visión, junto con los entornos de aprendizaje por refuerzo en NeMo Gym.
NVIDIA NIM empaqueta el modelo como un microservicio listo para producción, con configuraciones validadas y optimizadas para rendimiento y soporte de nivel empresarial, actualizado cada dos semanas con parches de seguridad y mejoras de rendimiento.
Y con el modelo en ejecución en NVIDIA Dynamo, las organizaciones pueden atender hasta 8x más usuarios con 85% menos de latencia.
Nemotron 3.5 Super VL ya está disponible en Hugging Face, en Open Router, en la comunidad ModelScope y como NVIDIA NIM.
Se ejecuta en DGX Station, RTX PRO y GeForce RTX
Nemotron 3.5 Super VL se ejecuta en toda la línea de hardware de NVIDIA: en DGX Station, en sistemas RTX PRO y RTX para inteligencia local en el equipo de escritorio, en NVIDIA Jetson en el edge, y en entornos de data center y nube.
Nemotron 3.5 Bolt 74B-A9B 24GB ya está disponible en Hugging Face, con soporte para llama.cpp, Ollama, LM Studio, Unsloth y vLLM. Se ejecuta en PCs GeForce RTX, en DGX Station y en workstations RTX PRO.
Descargue los pesos abiertos, explore los recursos de personalización con NVIDIA NeMo o lea el blog técnico para el desglose completo de la arquitectura.
Manténgase al día sobre agentes, NVIDIA Nemotron y más suscribiéndose a las noticias de NVIDIA, uniéndose a la comunidad y siguiendo a NVIDIA AI en LinkedIn, Instagram, X y Facebook.
Explore tutoriales en video y transmisiones en vivo a su propio ritmo.
Consulte el aviso sobre información de productos de software.