
Cuando surgió la COVID-19, los científicos tenían una ventaja decisiva: décadas de investigación previa sobre coronavirus significaban que entendían las proteínas clave del virus lo suficiente para diseñar vacunas en tiempo récord. La próxima pandemia podría no ofrecer la misma ventaja inicial.
Para mejorar esas probabilidades, NVIDIA se sumó a una coalición de organizaciones de investigación de todo el mundo, entre ellas Google DeepMind y el European Bioinformatics Institute (EMBL-EBI), del European Molecular Biology Laboratory, para liberar las estructuras 3D predichas de los complejos proteicos de más de 2,800 virus, abiertas a cualquier científico, en cualquier lugar, a través de AlphaFold Database.
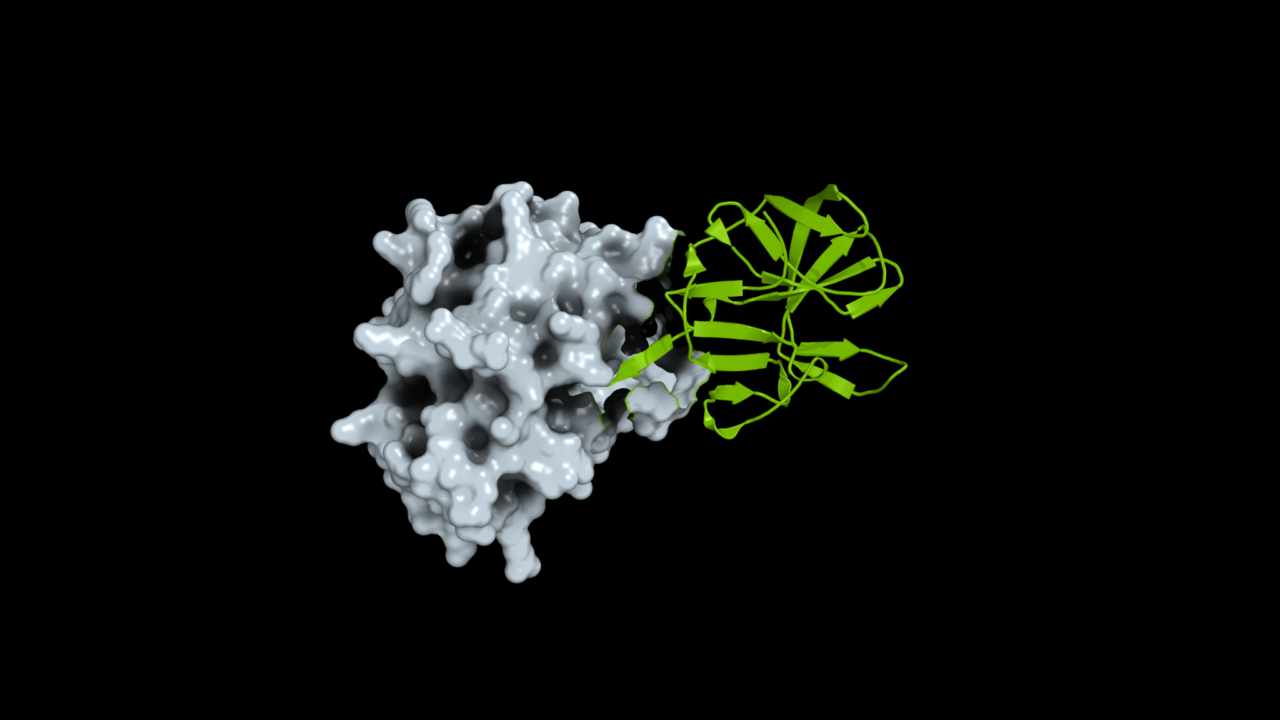
Las estructuras del conjunto de datos recién liberado se infirieron con AlphaFold2, el modelo de IA de Google DeepMind que predice cómo se pliegan las proteínas en formas tridimensionales, con optimización de NVIDIA BioNeMo Inference Runtime. Esto permitió al equipo escalar la inferencia a miles de proteomas virales y predecir los complejos, o grupos de proteínas que interactúan entre sí, codificados dentro de cada virus.
«Nuestra ambición con AlphaFold Database siempre ha sido democratizar el acceso a la biología fundamental a escala», declaró Risha Patel, gerente de alianzas en ciencias de la vida de Google DeepMind. «Esta colaboración, que incorpora miles de complejos virales a la base de datos, va a equipar a científicos de todo el mundo con la información que necesitan para prepararse ante brotes futuros.»
NVIDIA también está liberando de forma abierta el BioNeMo Structure Prediction Pipeline, el flujo de trabajo acelerado por GPU que se usó para generar el conjunto de datos, para que los investigadores puedan ir de la secuencia de la proteína a la estructura 3D predicha en sus propios objetivos de estudio.
La preparación para la próxima pandemia tiene que empezar ahora. Un análisis del Center for Global Development estima cerca del 50% de probabilidad de que el mundo enfrente para 2050 una pandemia tan grave como la de COVID-19.
«Cuando ocurra la próxima pandemia, puede aparecer algo totalmente inesperado, y nos va a faltar el conocimiento que teníamos para la COVID», declaró Joe Grove, profesor de virología molecular en el Medical Research Council-University of Glasgow Centre for Virus Research y colaborador del proyecto. «Lo que intentamos hacer es acumular parte de ese conocimiento por anticipado.»
Cerca del 30% de las interacciones entre proteínas que se están agregando a la base de datos son completamente nuevas para la ciencia y muestran formas de interacción que nunca se habían documentado en el Protein Data Bank, el principal repositorio de estructuras proteicas determinadas de forma experimental. Esto se traduce en información nueva para que la comunidad biológica la explore y la aproveche en la generación de conocimiento.
«Esta base de datos es un motor de generación de hipótesis», declaró Chris Dallago, líder del equipo de investigación aplicada en biología digital de NVIDIA. «Estamos permitiendo que biólogos y la comunidad de IA investiguen las interacciones entre proteínas, no solo como moléculas aisladas, sino como complejos, para que todo el campo avance.»
Predecir Estructuras de Complejos Proteicos
La mayoría de las proteínas no trabajan solas: se unen en complejos de varias moléculas para cumplir funciones sofisticadas. Esas estructuras suelen ser justamente el blanco que una vacuna o un medicamento debe alcanzar para interrumpir la función viral.
Entender la estructura 3D de la proteína spike del virus de la COVID-19, por ejemplo, resultó fundamental para el diseño de las vacunas. Para miles de otros virus no existe hoy ningún conocimiento estructural equivalente. Este conjunto de datos empieza a llenar ese vacío.
Los métodos tradicionales para determinar estructuras proteicas, que pasan por cristalizar las proteínas y dispararles rayos X, pueden tardar años y costar miles de dólares por estructura. AlphaFold2, optimizado con NVIDIA BioNeMo para ejecutarse de forma eficiente en las GPU NVIDIA, predice una estructura en minutos y puede ejecutarse por lotes. Los científicos pueden después verificar las predicciones de alta confianza con métodos experimentales.
En este proyecto, el equipo recorrió de forma sistemática las estructuras proteicas de familias virales que se sabe que infectan a humanos, desde los virus del resfriado común hasta amenazas emergentes como la Mpox.
Una Colaboración Global con Acceso Global
La colaboración reúne a la Coalition for Epidemic Preparedness Innovations, el EMBL-EBI, Google DeepMind, NVIDIA, la Universidad Nacional de Seúl, la Universidad Sungkyunkwan, el Swiss Institute of Bioinformatics y la Universidad de Glasgow.
La liberación del conjunto de datos contribuye a AlphaFold Database, que ahora reúne más de 260 millones de predicciones de proteínas y de complejos proteicos y cubre casi todas las proteínas que la ciencia tiene catalogadas. El anuncio coincide con una reunión de la Asamblea General de las Naciones Unidas convocada por el Foro Económico Mundial sobre prevención, preparación y respuesta ante pandemias, celebrada esta semana en Nueva York.
«Hacer que estos datos sean abiertos es esencial para entender los diagnósticos virales y desarrollar tratamientos y vacunas», declaró Jo McEntyre, directora interina del EMBL-EBI. «El conjunto de datos también cubre virus menos estudiados y reduce las barreras para los científicos que trabajan en contextos con pocos recursos y enfrentan los brotes en primera línea.»
Las predicciones del conjunto de datos abierto vienen etiquetadas por nivel de confianza. Las estructuras muestran cómo podrían verse los complejos virales y cómo podrían interactuar las proteínas individuales dentro de un proteoma viral.
En conjunto, los nuevos datos representan una contribución importante a la información disponible para los científicos de biología digital y de investigación en enfermedades.
«Cuando hice mi doctorado, no había estructuras para ninguna de las proteínas que investigábamos. Era como trabajar a ciegas: teníamos que adivinar lo que estaba pasando», declaró Grove. «Este conjunto de datos es una herramienta poderosa para todas las personas que hacen su doctorado ahora, porque les da datos estructurales de alta calidad que van a acelerar la ciencia fundamental.»
Explore el conjunto de datos de complejos proteicos virales en el AlphaFold Database Pandemic Preparedness Portal, prediga estructuras para objetivos proteicos con el BioNeMo Structure Prediction Pipeline y conozca más sobre NVIDIA BioNeMo.