
Las fábricas de IA se construyen por megawatt, a veces por gigawatt. Cada megawatt de fábrica cuesta cerca de 60 millones de dólares, y quien opera una fábrica de IA solo compromete capital a esa escala con una visión clara del retorno de la inversión. Tres factores definen ese retorno:
- Capacidad de generación de ingresos: cuánto podría facturar la fábrica en un año si vendiera todos los tokens que puede producir.
- Vida útil: cuánto tiempo sigue generando ingresos el hardware de IA.
- Demanda: cuánta demanda hay por esos tokens.
La fortaleza en un factor no compensa del todo la debilidad en otro. Una alta capacidad de generación de ingresos vale poco si la fábrica vende solo una parte de lo que puede producir. Una alta demanda importa poco si la fábrica deja de producir a plena capacidad después de apenas un año. Los tres factores tampoco son independientes: una fábrica capaz de ejecutar más tipos de carga de trabajo encuentra más demanda, lo que la mantiene generando ingresos año tras año.
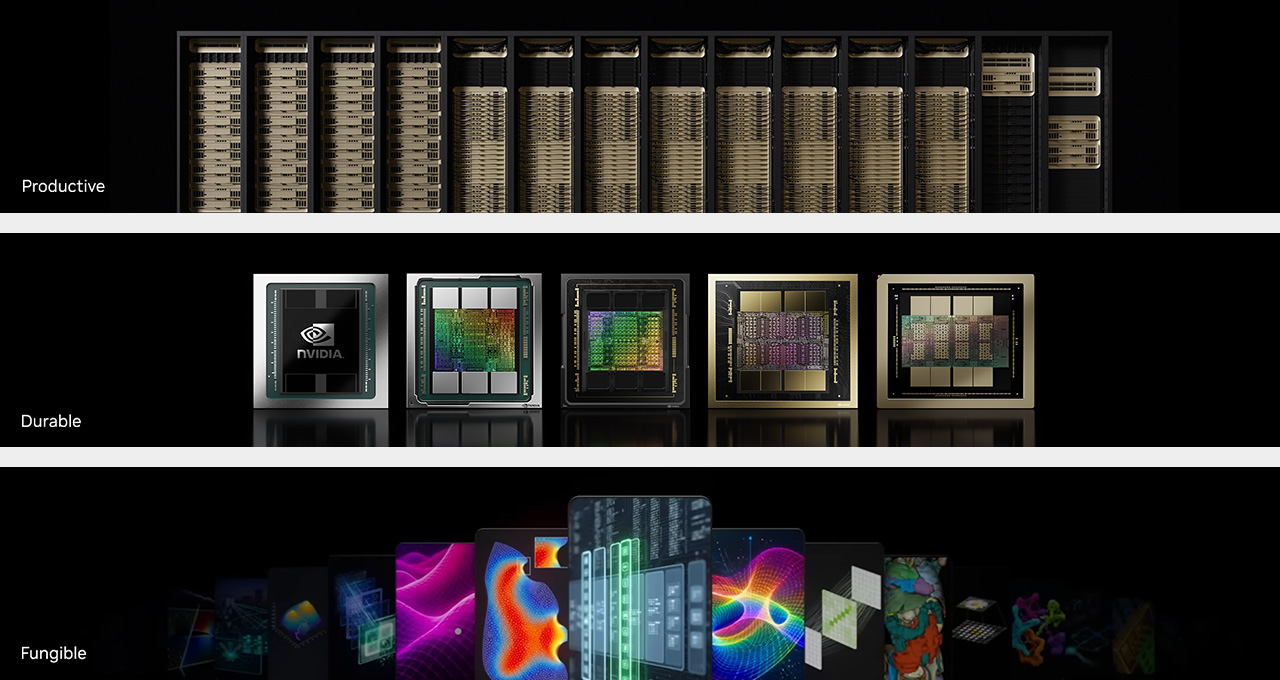
Las fábricas de IA de NVIDIA están diseñadas para maximizar los tres. Son:
- Productivas: entregan la mayor tasa de transferencia por megawatt y el menor costo por token, lo que maximiza su capacidad de generación de ingresos.
- Duraderas: las GPU y los sistemas NVIDIA siguen generando ingresos años después de su envío, lo que amplía la vida útil.
- Fungibles: ejecutan todo tipo de IA, en todas las fases y en todos los lugares, además de muchas cargas de trabajo que no involucran IA, lo que profundiza y amplía la demanda que pueden atender.
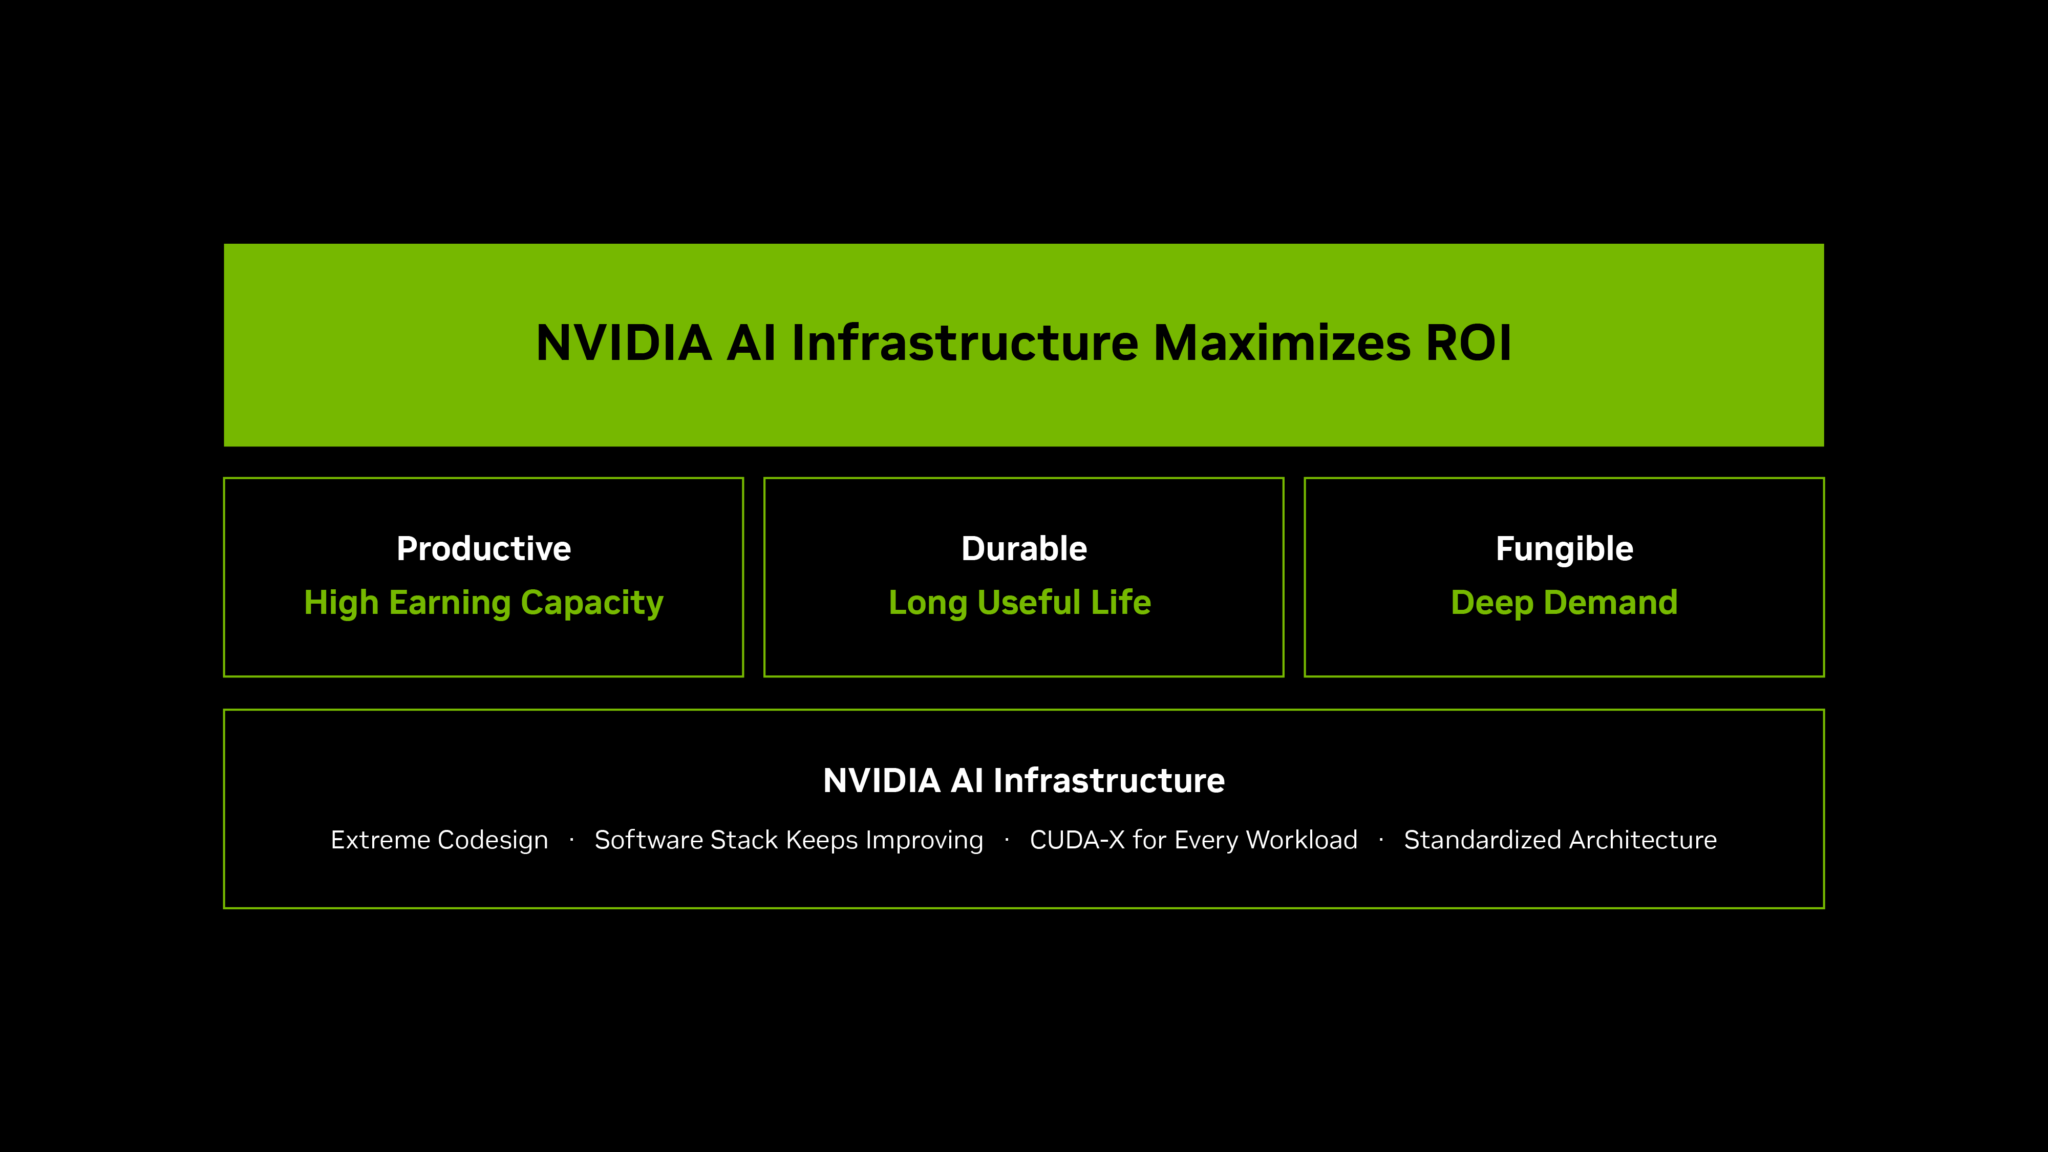
El codiseño de ingeniería en todo el stack maximiza la tasa de transferencia de la fábrica de IA, y la optimización continua de software mantiene productivo el hardware ya instalado años después de su envío. Las bibliotecas NVIDIA CUDA-X permiten que una fábrica ejecute cualquier carga acelerada. Una arquitectura estandarizada pone todo eso al alcance de cualquier operador, con despliegue a partir de un diseño de referencia validado.
Productivas: Mayor Número de Tokens por Megawatt y Menor Costo por Token
La energía es la restricción que limita a una fábrica de IA. Esto convierte a los tokens por segundo por megawatt en el número que gobierna la capacidad de generación de ingresos. Más tokens dentro de un mismo límite de potencia significan más ingresos. Un menor costo por token significa más margen sobre ellos.
Datos de SemiAnalysis AgentX muestran que los sistemas NVIDIA Vera Rubin NVL72 entregan una tasa de transferencia por megawatt más de 30x mayor que la del NVIDIA GB300 NVL72, y un costo por millón de tokens hasta 45x menor en el modelo DeepSeek V4 Pro. Ganancias de ese orden provienen del codiseño extremo en todo el stack: desde los modelos y las cargas de trabajo, pasando por el software, hasta el cómputo, la red y la memoria, todo optimizado en conjunto.
De ahí surgen dos preguntas. Si cada generación abarata los tokens de forma drástica, ¿la demanda de cómputo se reduce?
No, se expande.
Los tokens más baratos hacen que más casos de uso sean económicamente viables, y esos casos de uso consumen más tokens de los que la eficiencia ahorró.
La segunda pregunta es sobre durabilidad. Si cada generación es tan superior a la anterior, ¿qué pasa con las generaciones más antiguas?
Duraderas: La Base Instalada Sigue Generando Ingresos
No toda carga de trabajo necesita el sistema más nuevo. El encaje correcto depende de la complejidad y la forma de la carga, y por eso la generación anterior sigue generando ingresos después de que llega la siguiente.
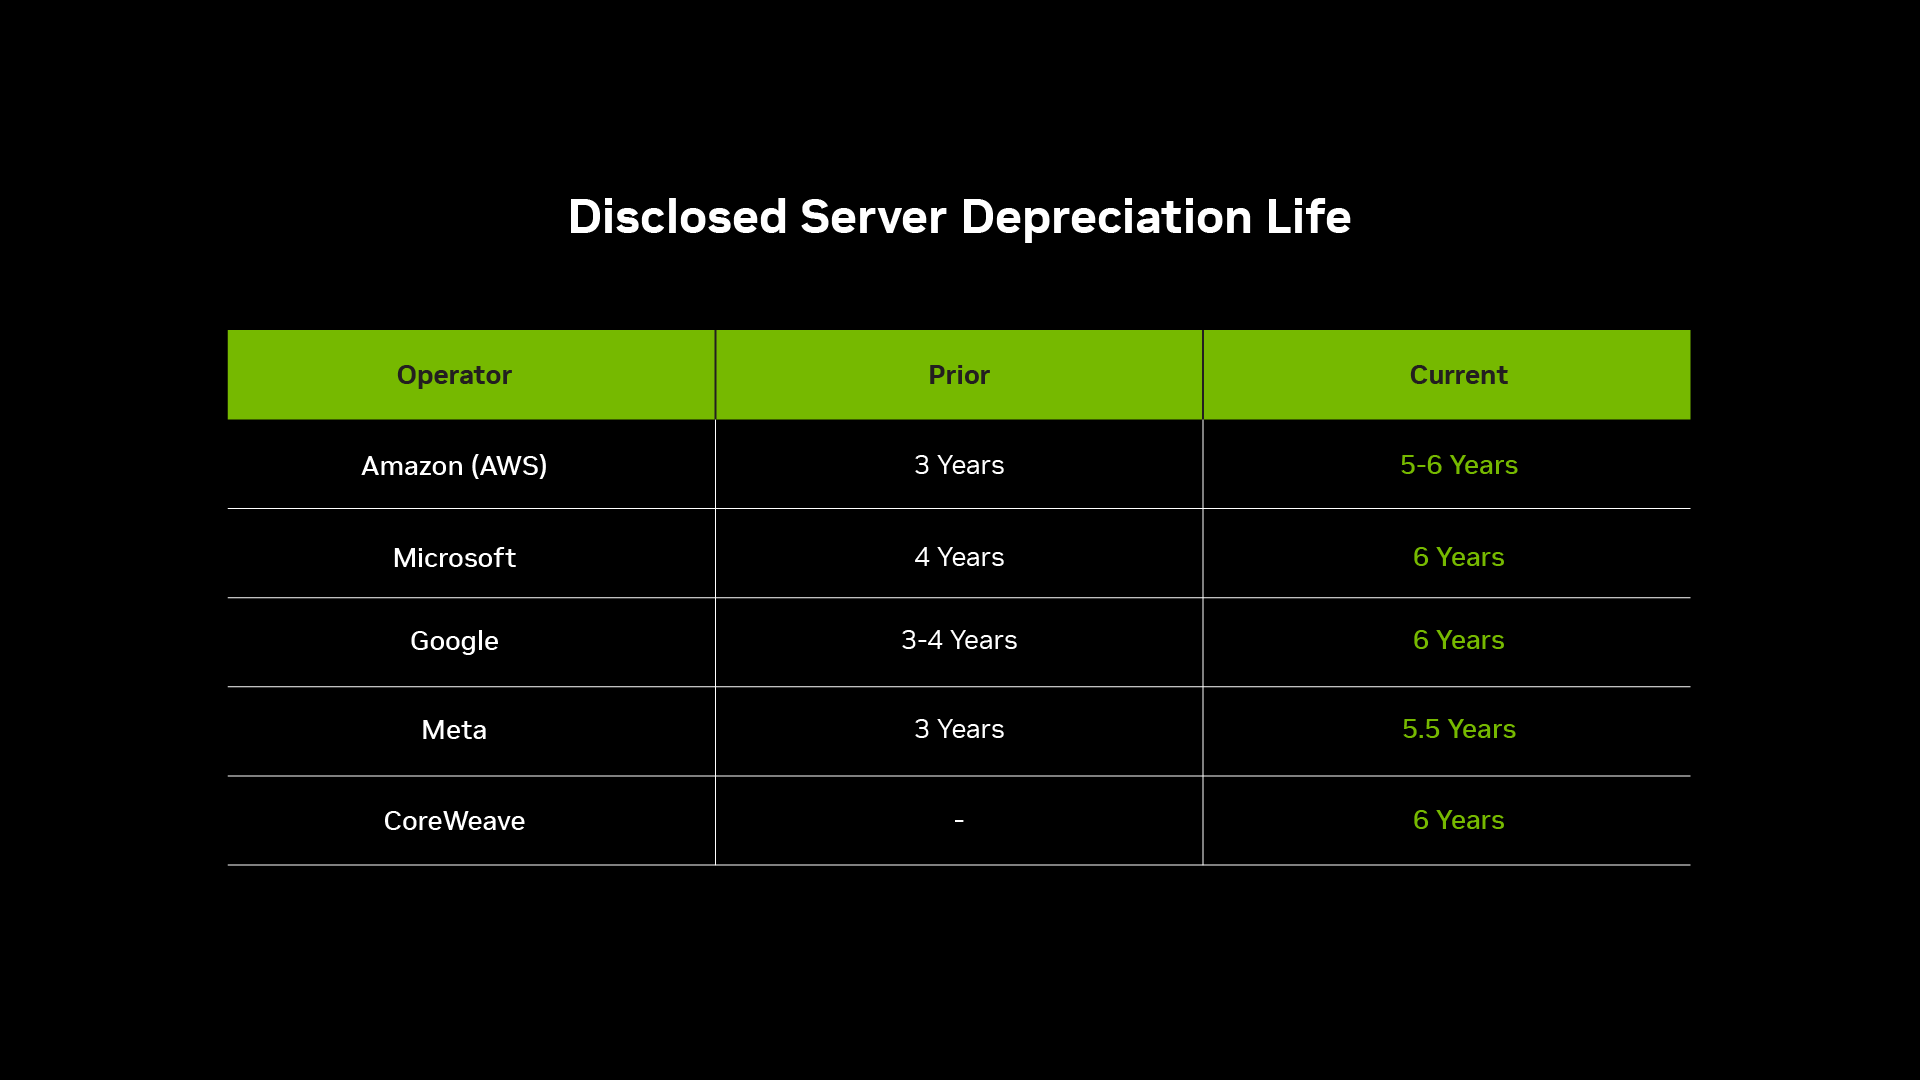
La GPU NVIDIA A100 empezó a enviarse en 2020 y sigue en servicio comercial seis años después, lo que demuestra su valor económico continuo. CoreWeave extendió hace poco hasta 2029 las reservas de unidades lanzadas en 2020. Con los años, todos los grandes operadores han extendido el calendario de depreciación de sus servidores, que es una apuesta sobre cuándo el hardware deja de generar ingresos, y una apuesta que no deja de empujarse hacia adelante. Un análisis de Sprout de septiembre de 2026, «The Productive Life of a Data Center GPU«, da seguimiento a cómo ha cambiado ese calendario en todos los grandes operadores.
Barkr estima la vida útil en cinco a seis años para un sistema de ocho GPU H100 y en nueve a diez años para el GB300 NVL72, con base en el valor de reventa de esos sistemas. Silicon Data muestra que una GPU A100 de seis años todavía vale una cuarta parte de lo que costó, mientras que un calendario de depreciación de cinco años ya la había puesto en cero hace más de un año. Ornn Data constata que el mercado paga el 80% del valor para rentar una GPU A100 en un contrato de cinco años frente a uno de un mes.
CUDA, la plataforma de software con la que se programan las GPU NVIDIA, funciona en todas las generaciones, así que nada de lo que un operador ya tiene queda varado cuando llega una arquitectura nueva. La optimización continua de software y de kernels sigue mejorando lo que puede hacer el hardware existente.
La misma plataforma ejecuta machine learning, deep learning, IA generativa, razonamiento, IA basada en agentes e IA física. Cada nuevo tipo de trabajo llegó a hardware que ya estaba instalado.
Eso es fungibilidad. Cuantos más tipos de trabajo acepta un sistema, más tiempo sigue encontrando trabajo.
Fungibles: Todo Tipo de IA, en Todas las Fases, en Todos los Lugares
Una fábrica construida para un solo tipo de trabajo es una apuesta a que ese trabajo va a seguir existiendo. Una fábrica que ejecuta todo sigue siendo útil y generando ingresos incluso cuando el trabajo cambia.
Las fábricas de IA de NVIDIA ejecutan todo tipo de modelo de IA, abierto y propietario, en lenguaje, visión, biología, física y robótica. Ejecutan todas las fases, desde el procesamiento de datos hasta el preentrenamiento, el postentrenamiento y la inferencia. Y se ejecutan en todos los lugares, desde nubes a hiperescala y nubes de IA hasta programas de IA nacional, centros de datos corporativos y el edge.
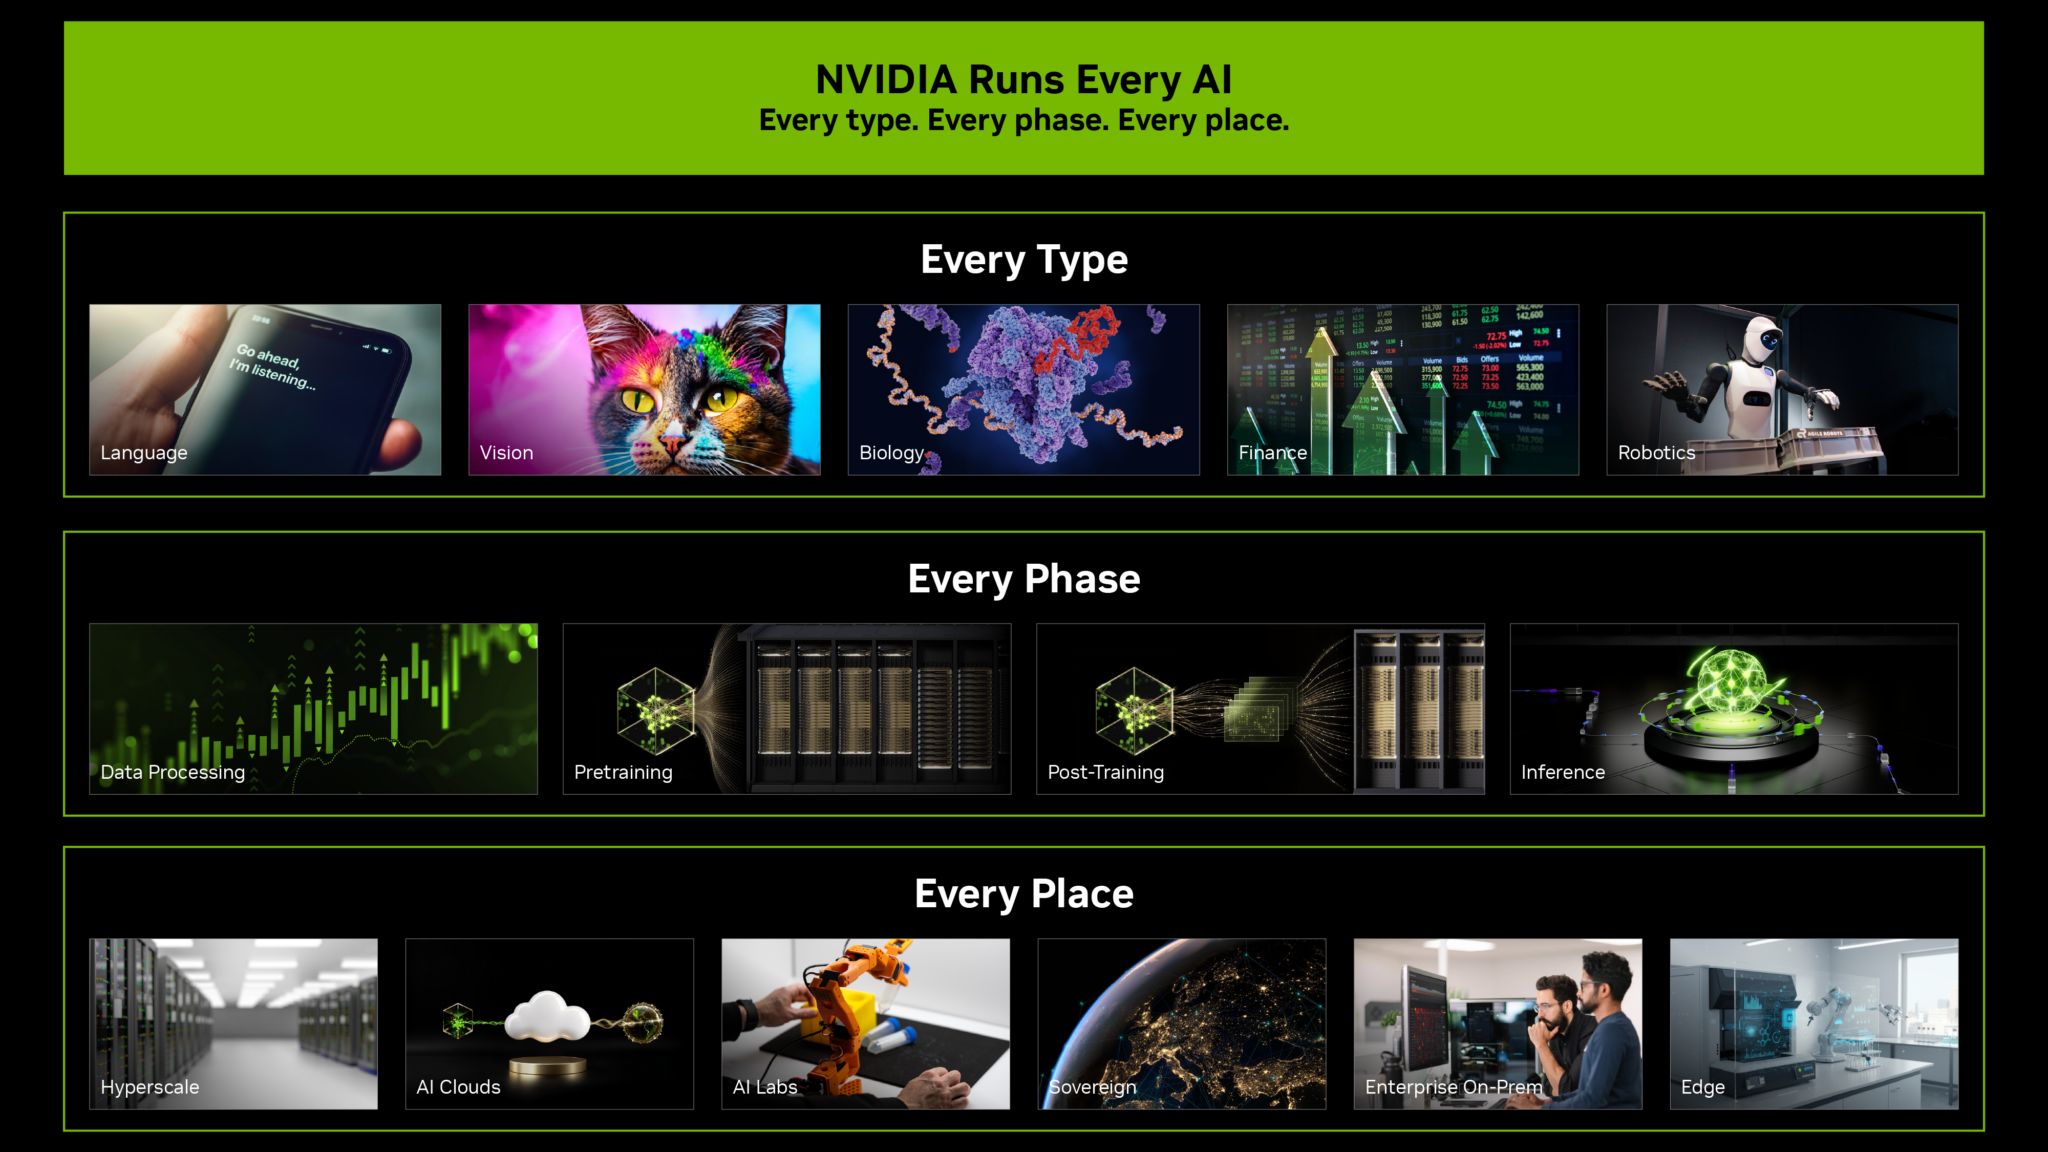
No todo eso es construir y ejecutar modelos de IA. La misma infraestructura ejecuta procesamiento de datos, cómputo científico, simulación, gráficos y más.
Todas esas cargas de trabajo, de IA y fuera de la IA, se reducen a la misma matemática paralela, y las GPU NVIDIA están hechas para ejecutar exactamente eso en miles de núcleos a la vez. CUDA es la razón por la que un mismo chip puede simular la luz, plegar una proteína y predecir el siguiente token. Más de mil bibliotecas CUDA-X listas para usar se apoyan en eso, y cubren desde redes neuronales profundas, litografía computacional y simulación de circuitos cuánticos hasta búsqueda vectorial y modelado climático, con más de 10 millones de desarrolladores construyendo sobre ellas.
Eso es lo que hace de las GPU NVIDIA cómputo acelerado de propósito general, y no un ASIC personalizado para una sola carga de trabajo. Ser de propósito general no significa ser genérico: los Tensor Cores y el Transformer Engine colocan hardware optimizado para IA dentro de una arquitectura programable, y entregan especialización y flexibilidad en el mismo chip. Una sola arquitectura que ejecuta todo es lo que mantiene alta la utilización, y con ella el retorno.
Esa versatilidad aparece en producción entre los clientes:
- Lilly: construye y ejecuta modelos de proteínas, de moléculas pequeñas y de genómica en un cluster on-premises de 1,016 GPU, además de chatbots y flujos de trabajo basados en agentes para sus propios equipos.
- Pinterest: hace postentrenamiento y despliegue de un modelo de visión y lenguaje en una nube a hiperescala, en 14,000 GPU que abarcan las arquitecturas NVIDIA Blackwell, Hopper y anteriores.
- Revolut: procesa datos de miles de millones de registros de transacciones con NVIDIA cuDF y después entrena y despliega un modelo fundacional en una nube de IA.
- Runway: entrena un world model en NVIDIA Hopper y lo pone a servir en la plataforma NVIDIA Blackwell, con infraestructura en la nube.
- Texas A&M University: ejecuta simulación molecular y descubrimiento de fármacos con IA en su supercomputadora, con una utilización del 95% al 98% en 26 proyectos y siete instituciones.
Lo mismo vale más allá de la IA. Cosm opera un centro de datos distribuido impulsado por NVIDIA que aporta recursos flexibles de cómputo para reproducción de video en alta resolución, streaming, gráficos en tiempo real y visualización sincronizada. Dassault Systèmes sostiene la simulación de gemelo virtual detrás de la certificación de aeronaves en Wichita State University y del diseño de vehículos en Lucid Motors. Y Unilever crea imágenes de producto a partir de gemelos digitales en lugar de sesiones de fotos, y reduce a la mitad el costo de producción.
Ninguna lista de ejemplos aquí sería completa, y ese es justamente el punto.
Las fábricas de IA de NVIDIA están diseñadas para ser productivas, duraderas y fungibles: tokens más rentables, vida útil más larga y demanda más profunda. Eso es lo que maximiza su retorno.