
El rendimiento del sistema, la escalabilidad eficiente de la infraestructura y la optimización continua del software son las palancas que determinan la economía de la inferencia de IA. Más rendimiento del sistema significa más tokens generados y, por lo tanto, más ingresos. Escalar de forma eficiente significa que el throughput crece proporcionalmente conforme se agrega hardware, lo que exige menos recursos para atender usuarios a escala. La optimización continua significa extraer más valor de las inversiones en infraestructura.
Detrás de las tres está la fungibilidad de la plataforma: la misma infraestructura ejecuta cualquier modelo y cualquier carga de trabajo, de entrenamiento a inferencia, de recomendación a razonamiento, de lenguaje a video, y mantiene alta la utilización.
La plataforma NVIDIA fue construida para optimizar todos estos puntos, como muestran los resultados de MLPerf Inference v6.1 publicados hoy:
- El sistema NVIDIA Vera Rubin NVL72 debuta con un desempeño destacado: en su primera presentación en preview a MLPerf Inference, NVIDIA Vera Rubin NVL72 entrega hasta 3.7x más throughput que GB300 NVL72.
- NVIDIA GB300 NVL72 escala con alta eficiencia: una presentación con 288 GPU en cuatro racks GB300 NVL72 alcanzó 99% de eficiencia de escalabilidad, con el throughput creciendo de forma casi lineal respecto a la base de un rack.
- Las optimizaciones continuas de software generan ganancias de rendimiento: las optimizaciones de software en las presentaciones de NVIDIA a MLPerf Inference v6.1 entregaron hasta 1.6x más rendimiento que la v6.0. Las optimizaciones continuaron después de la presentación de la v6.1, con ganancias adicionales.
Para las organizaciones que están decidiendo sobre infraestructura de IA, el rendimiento, la eficiencia de escalabilidad y la velocidad del software son consideraciones importantes, porque determinan la economía de la inferencia en el largo plazo.
Vera Rubin NVL72 debuta en MLPerf Inference con un desempeño destacado
NVIDIA presentó resultados en preview de Vera Rubin NVL72 en dos de los benchmarks más exigentes de la suite MLPerf Inference v6.1: DeepSeek-R1 y Qwen3-VL.
Vera Rubin NVL72 entrega hasta 3.7x más throughput que GB300 NVL72 en Qwen3-VL en los escenarios offline, server e interactive, con vLLM y el framework de inferencia open source NVIDIA Dynamo. En DeepSeek-R1, con la biblioteca NVIDIA TensorRT-LLM, el throughput es hasta 2.5x mayor que el de GB300 NVL72. Estos resultados iniciales muestran el ritmo de innovación de NVIDIA y cómo el rendimiento mejorará con optimizaciones continuas de software.
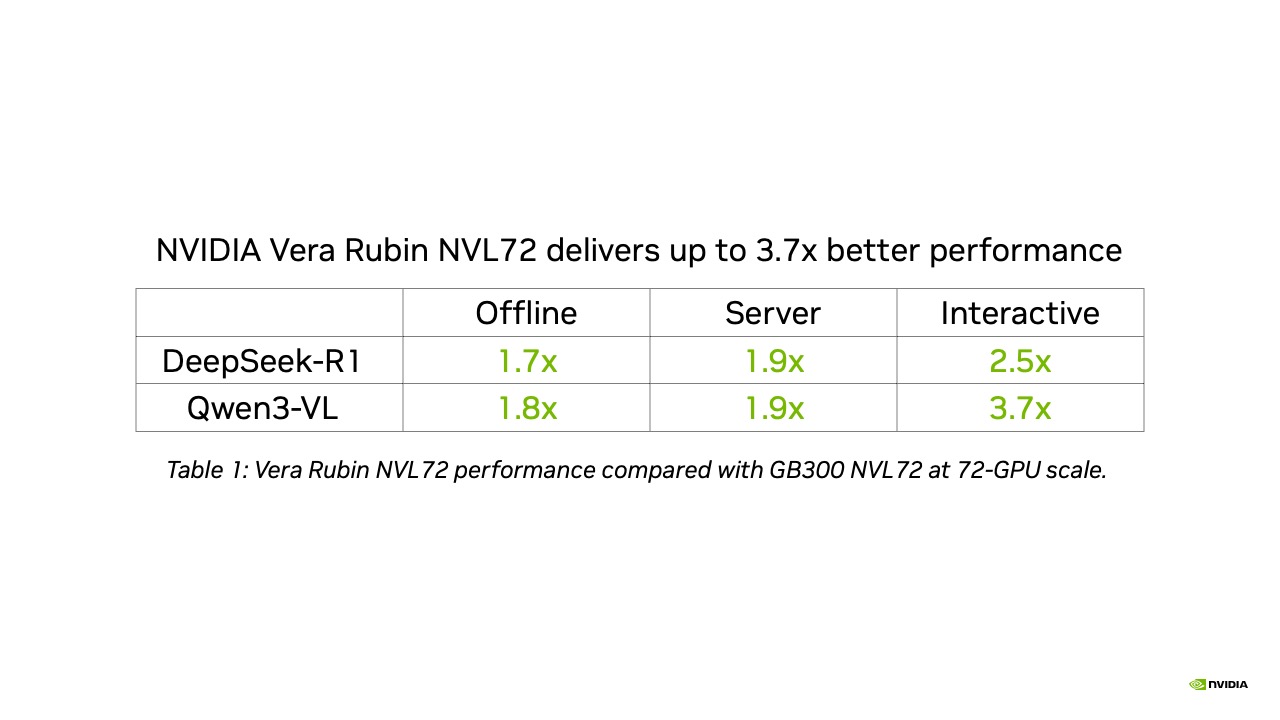
En la práctica, cada rack Vera Rubin NVL72 entrega muchos más tokens, atiende a más usuarios y genera más ingresos que un rack GB300 NVL72, y reduce el costo por token.
Los resultados reflejan un codiseño full-stack entre hardware y software. Los Tensor Cores y el Transformer Engine mejorados de Vera Rubin aceleran tanto la fase de prefill como la de decode de la inferencia, mientras que la precisión NVFP4 reduce el consumo de memoria en pesos del modelo, attention y KV cache, lo que aumenta el throughput con una pérdida mínima de calidad en la salida.
Las presentaciones de Vera Rubin usaron ampliamente serving desagregado, separando prefill y decode, junto con paralelismo de expertos a gran escala para lograr máxima eficiencia en las capas mixture-of-experts que sostienen modelos como DeepSeek-R1 y Qwen3-VL.
El dominio de scale-up de NVL72, con la sexta generación de NVIDIA NVLink y NVLink Switch, entrega tasas de paquetes 10x mayores y latencia 3x menor que Ethernet estándar, y es la base de interconexión que hace efectivas estas técnicas a escala de rack.
Este codiseño se extiende al ecosistema de socios de NVIDIA: Nebius también presentó resultados en preview de Vera Rubin NVL72 y demostró un excelente rendimiento.
Los agentes de IA, que razonan, planean y actúan en varios pasos, están cambiando la forma de medir el rendimiento de inferencia. En benchmarks diseñados para capturar este cambio, como SemiAnalysis AgentX, Vera Rubin NVL72 entregó un rendimiento 30x mejor que GB300 NVL72 en pruebas de preview. Además, el próximo benchmark MLPerf Endpoints traerá medición estandarizada para cargas de inferencia con agentes, más allá de lo que capturan los benchmarks tradicionales de throughput.
NVIDIA GB300 NVL72 escala con alta eficiencia
La eficiencia de escalabilidad, es decir, cuánto se convierten las GPU adicionales en ganancia de throughput, es una medida central de productividad de la infraestructura de IA. NVIDIA lo logra con interconexiones de scale-up de alto ancho de banda y baja latencia dentro de cada rack, red de alto ancho de banda entre racks y orquestación eficiente de solicitudes entre nodos.
La presentación de NVIDIA en DeepSeek-R1 (DSR1) escaló de un rack GB300 NVL72 (72 GPU) a cuatro racks (288 GPU), y alcanzó 99% de eficiencia de escalabilidad en el escenario offline. El throughput creció casi en la misma proporción que el hardware agregado.
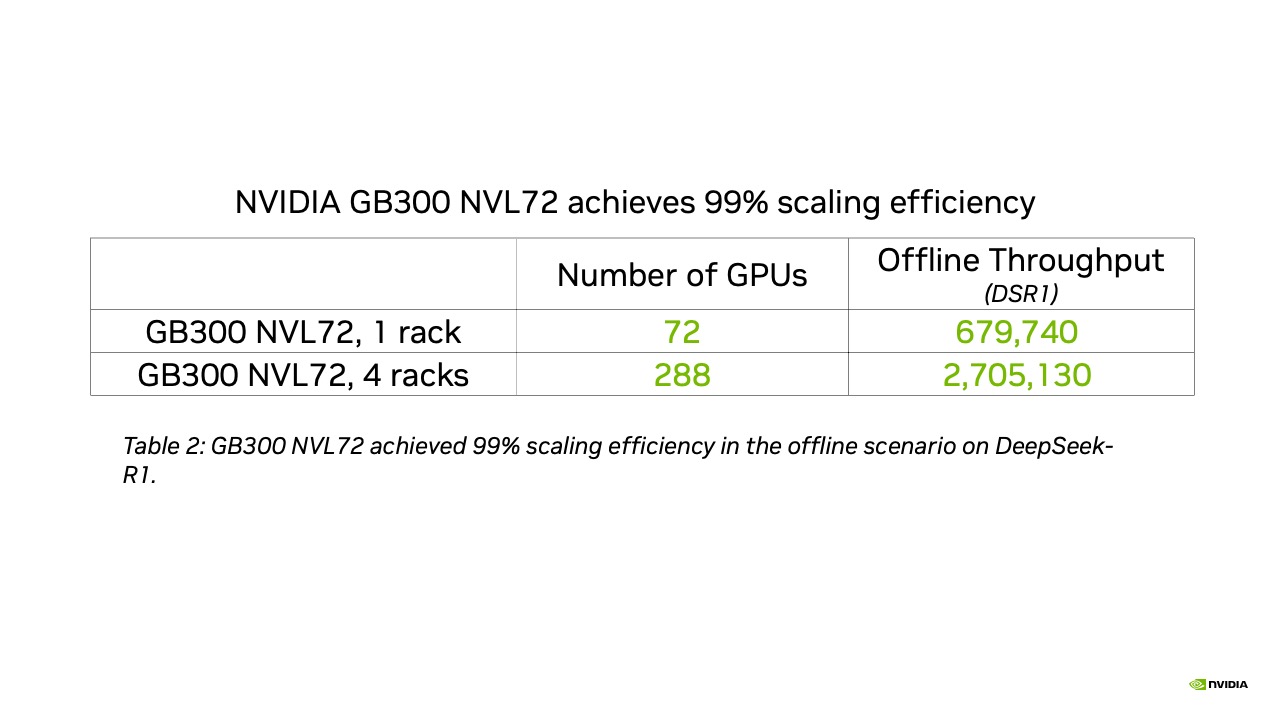
La eficiencia de escalabilidad es decisiva porque más GPU no significan automáticamente un throughput proporcionalmente mayor. Si casi duplicar la cantidad de GPU entregara solo una ganancia de un dígito porcentual en throughput, el costo de infraestructura superaría por mucho el retorno en rendimiento. La arquitectura, la interconexión y el software tienen que escalar en conjunto.
GB300 NVL72 también demostró eficiencia a escala de rack en el benchmark de texto a video WAN 2.2, y llegó a 0.65 videos 720p por segundo a 5.7 segundos por video, con un throughput 9x mayor y una latencia 7.5x menor que un solo nodo.
Las optimizaciones de software generan ganancias continuas
La plataforma NVIDIA pasa por un desarrollo continuo de software, con mejoras de rendimiento y de funciones.
En la v6.1, el rendimiento de GB300 NVL72 en Qwen3-VL mejoró hasta 1.6x respecto a los resultados de la v6.0. Las ganancias vinieron de menor precisión en el KV cache, más fusión de kernels, mejores kernels y serving desagregado con vLLM y NVIDIA Dynamo.
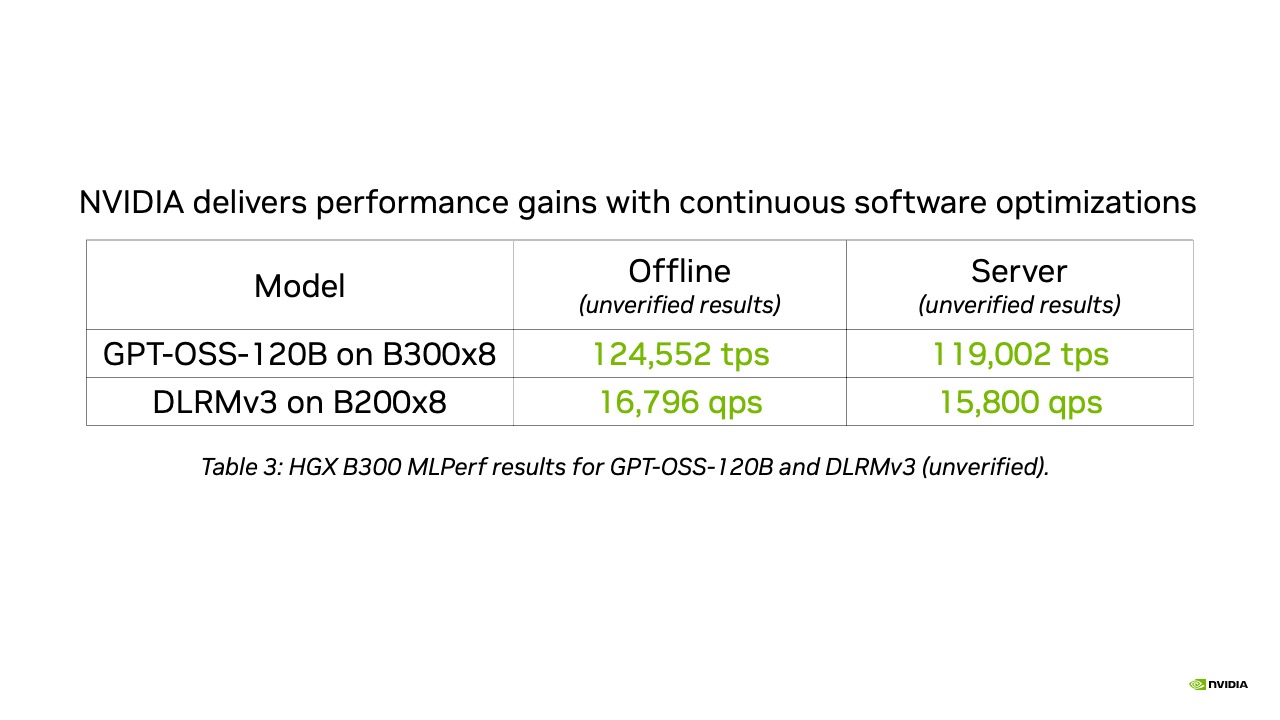
La optimización de software siguió después de la fecha límite de presentación de la v6.1. Los resultados posteriores a la presentación, todavía no verificados por MLCommons, en GPT-OSS-120B y DLRMv3 muestran ganancias adicionales de rendimiento.
Inferencia de IA a cualquier escala
Además de los resultados de la plataforma NVIDIA Grace Blackwell y Vera Rubin NVL72, NVIDIA presentó resultados de Jetson AGX Thor con NVIDIA TensorRT Edge-LLM en el nuevo benchmark Edge-Agentic, con Qwen3.6-27B.
El ecosistema de socios de NVIDIA participó de forma amplia, con 19 socios, ocho de ellos en sistemas Blackwell NVL72 multinodo, y demostró un excelente rendimiento. Entre ellos: ASUS, Azure, Cisco, CoreWeave, Crusoe, Dell Technologies, Fujitsu, Giga Computing, HPE, Inventec, Lambda, MiTAC Computing, Nebius, Oracle Cloud Infrastructure, Quanta Cloud Technology, Red Hat, ScitiX, Supermicro y Wiwynn.
De dispositivos compactos en el borde a las grandes fábricas de IA, NVIDIA sigue avanzando en rendimiento en toda la stack, con una cadencia anual de arquitecturas de plataforma, software en mejora continua y un ecosistema construido para entregarlo a escala.
Conozca más sobre la plataforma NVIDIA Vera Rubin.